PR|この記事にはアフィリエイト広告(A8.net)が含まれます。
CodexやChatGPT WorkでGPT-6 Astraを使うと、5時間の利用枠や週の枠が思ったより早く尽きることがあります。なぜこんなに減るのか、どうすれば抑えられるのか、上限に来たら何ができるのかを、OpenAIの公式資料をもとに整理しました。
Astraの消費が多いのは、1トークンあたりのクレジット単価が高いからです。Codexの料金ページでは、Astraの単価は入力・出力ともGPT-6.1 Solの5倍、GPT-5.6 Solの2.5倍に設定されています。そこへ推論レベル、Fast mode、渡す文脈の量が重なると、消費はさらに増えます。抑えるには、まず推論レベルを低めから始めてFast modeを切ってください。日常の作業はGPT-6.1 SolやLunaに任せ、渡す資料も絞ります。上限に達したら、設定の利用状況画面でどの枠が尽きたかを確かめましょう。そのうえでリセットを待つか、保存済みのリセットやクレジットを使います。
- 利用枠はトークン量で減ります。Astraは100万トークンあたり入力250・出力1,250クレジットで、GPT-6.1 Sol(50・250)の5倍、GPT-6 Luna(2.5・12.5)の100倍です。
- 公式が勧める節約の中心は推論レベルの調整です。AstraのLowはSolのHighを上回ることがあるとヘルプに書かれています。Fast modeはプランの枠を標準の2.5倍、画像生成は平均3〜5倍の速さで使います。
- 上限に達したときの選択肢は、待つ、保存済みリセット、購入するリセット、クレジット(Plus・Pro)、Luna Reserve(一部のアカウント)です。モデルを切り替えても枠は戻りません。
自分のプランでAstraをどこで使えるか、5時間あたり何回が目安かは、プラン別に整理した次の記事で確かめられます。Plusで使える場所とChatのGPT-6 Proとの違いも、表で比べています。
情報確認日:2026年10月1日。OpenAIの公式ヘルプとCodexのドキュメント(料金ページ、モデル一覧、設定リファレンス)をまとめた解説です。2026年9月14日の公開後にGPT-6 Sol・Luna(9月22日)とGPT-6.1 Sol(9月29日)が加わり、料金ページの単価表と目安の表も改訂されたため、数字とモデル名を更新しました。

PR 生成AIを仕事で使う力をまとめて学ぶなら、DMM 生成AI CAMP 学び放題(職種別11コースが月額14,800円(税込16,280円)で学び放題)。先に仕組み・料金・解約条件の解説を読むこともできます。


なぜAstraは利用枠がすぐ減るのか
WorkとCodexは、プランに含まれる同じ利用枠を共有しています。プランによって5時間の枠と週の枠があり、両方に残りがないと作業を続けられません。5時間の枠はその時間内に使える量なので、5時間たつ前に使い切ることもあります。料金ページによると、Proプランには2026年10月1日時点で5時間の上限がありません。残量とリセット時刻は、設定の利用状況画面(Settings → Usage)で確認できます。
消費量はトークンで数えます。トークンはモデルが文章を読み書きするときの処理単位で、文字数とは一致しません。数えられるのは入力と出力の合計です。入力には今回の指示に加えて、会話の履歴、読み込んだファイル、AGENTS.md、ツールが返した結果が毎回含まれます。出力には、画面に出る回答とモデルが推論に使った分が入ります。推論レベルを上げると消費が増えるのはこのためです。
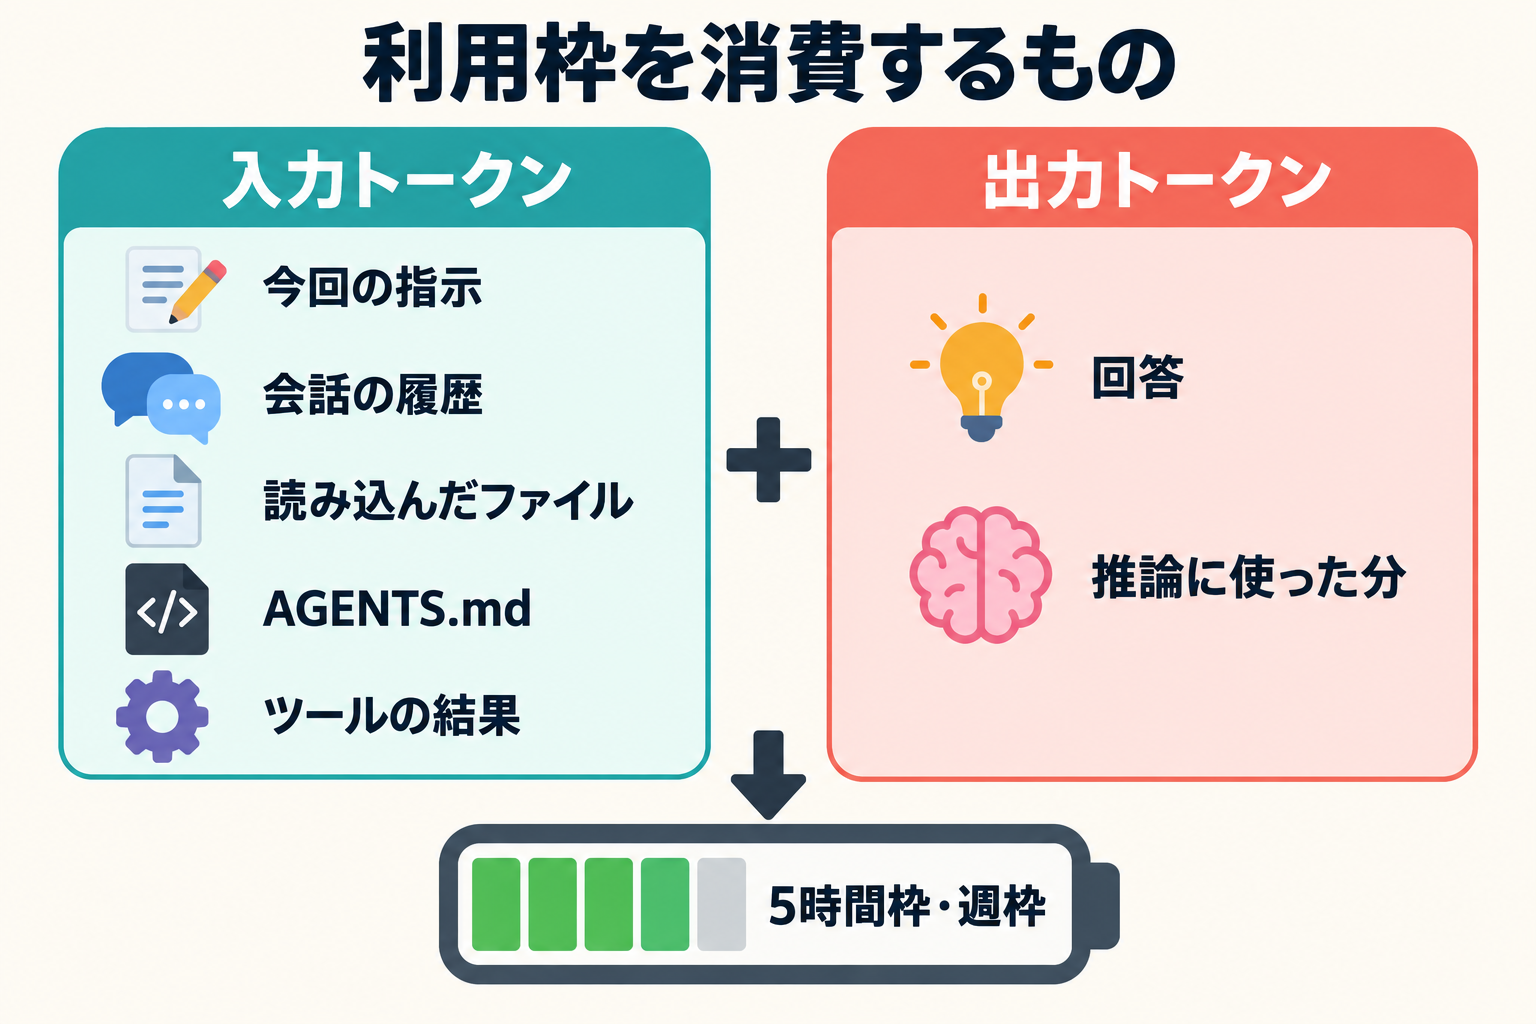
Codexの料金ページにあるモデル別の単価は次のとおりです。Astraは、ほかのモデルより1トークンあたりの単価がかなり高く設定されています。
| モデル | 入力 | キャッシュ済み入力 | 出力 |
|---|---|---|---|
| GPT-6 Astra | 250 | 25 | 1,250 |
| GPT-6.1 Sol | 50 | 2.5 | 250 |
| GPT-6 Sol | 50 | 5 | 250 |
| GPT-6 Luna | 2.5 | 0.25 | 12.5 |
| GPT-5.6 Sol | 100 | 10 | 500 |
| GPT-5.6 Terra | 50 | 5 | 300 |
| GPT-5.6 Luna | 5 | 0.5 | 30 |
料金ページは、GPT-5.6 Solの典型的なタスクで5〜30クレジットを目安に挙げています。Plusで5時間あたりに送れるローカルのメッセージ数の目安は、モデルごとに次のとおりです。
| モデル | Plusの5時間あたりの目安 |
|---|---|
| GPT-6 Astra | 5〜45 |
| GPT-6.1 Sol | 15〜160 |
| GPT-6 Sol | 15〜150 |
| GPT-6 Luna | 350〜3,000 |
同じ1メッセージでも、渡すファイルの量、応答の長さ、推論レベル、ツールを呼ぶ回数で消費は何倍も変わります。料金ページにも「見た目が似たタスクでも消費は異なり、指示文の長さだけでは見積もれない」との記載があり、ヘルプも長時間のタスクは短い依頼よりはるかに多く消費すると説明しています。目安の幅が5〜45と大きいのはこのためです。
Codexのリポジトリには、Plusで新しいセッションを始めて20分で上限に達したという利用者の報告があります(Issue #43201、2026年9月6日)。個別の環境での報告で、公開時の2026年9月14日に確認した時点ではOpenAIの回答は付いていませんでした。Astraを初期設定のまま長い作業に使うと、枠が短時間でなくなる場合があると考えておいてください。
設定で減らす:推論レベル・モデル・Fast mode
1. 推論レベルを低めから始める
公式ヘルプが最初に挙げる方法です。推論レベルはモデルとは別に選べます。低いレベルは「速い応答が欲しいときや、枠を長持ちさせたいときの出発点」とされています。高いレベルは難問向けですが、枠を多く使い、常に良い結果になるとは限りません。ヘルプには、低いレベルでも能力が下がるとは限らず、AstraのLowはSolのHighを上回ることがあるとも書かれています。SolのHighで満足しているなら、AstraのLowかMediumから試すのが公式の勧めです。
2026年10月1日時点のモデル一覧では、Astraは低めのLight(CLIや設定ファイルではlow)から始めるよう案内されています。デスクトップアプリとWebのWorkでは、入力欄の下にあるモデルと推論のコントロールで選ぶ形です。「Default」はモデルと推論レベルを1本のスライダーにまとめた選び方で、モデルを個別に選ぶと、そのモデルの推論レベルを指定できます。Codex CLIでは/modelで選ぶか、設定ファイルのmodel_reasoning_effortに書いておけます。
結果が足りないときも、すぐにレベルを上げる必要はありません。ヘルプは、指示が明確か、必要なファイル・接続アプリ・権限がそろっているかを先に確かめるよう勧めています。推論レベルを上げても、足りない情報や権限は補えないためです。
Codexのデスクトップアプリ・CLI・IDE拡張の違いや、最初の設定から確かめたい人は、初心者向けの解説記事を読むと、利用枠の考え方とあわせて全体の流れをつかめます。
2. MaxとUltraは最も難しいタスクだけにする
推論レベルには、High・Extra Highの上にMaxとUltraがあります。Maxは1つのタスクにより長い時間をかけて考える設定です。Ultraはサブエージェントを使い、作業を分けて並列に進めます。モデル一覧には「ほとんどのタスクにMaxやUltraは不要」とあり、推論レベルを上げると時間もトークンも増えると説明されています。サブエージェントはそれぞれがモデルとツールを動かすので、1つのエージェントで進めるより多くのトークンを使う仕組みです。Ultraを常用すると、枠は一気に減ります。
3. 日常作業はGPT-6.1 SolやLunaに任せる
2026年10月1日時点のモデル一覧は、使い分けを次のように説明しています。Astraはコード・アプリ・調査をまたぐ最も難しい作業向けです。GPT-6.1 SolはAstraに近い性能をより低いコストで出すモデルで、繰り返しの長い作業に向きます。Lunaは抽出・分類・変換・要約のように、良い結果の形が決まっている作業向けです。GPT-5.6のSol・Terra・Lunaも、新しいモデルへの移行期間中は選べます。
上の単価表のとおり、GPT-6.1 Solに切り替えるとクレジット単価はAstraの5分の1、GPT-6 Lunaなら100分の1です。料金ページも、消費が想定より多いときは、小さいモデルや作業範囲を絞った依頼で足りないかを考えるよう勧めています。GPT-6.1 Solは2026年9月29日からProを先頭に順に提供されているので、まだ表示されないアカウントではGPT-6 Solを選んでください。
GPT-6.1 SolがGPT-6 Solからどう変わり、Plusにいつ届くのかは次の記事で解説しています。無料・Go・PlusでGPT-6 SolとLunaを使える場所は、GPT-6 SolとLunaの解説記事で確かめられます。
4. Fast modeを切る
Fast modeは応答が速くなる代わりに、プランの枠を標準の2.5倍の速さで使うモードです。購入したクレジットでは標準の2倍です。Codex CLIでは/fastでオンとオフを切り替えます。既定でオンにする設定は、config.tomlのservice_tier = "fast"と[features].fast_mode = trueの組み合わせです。心当たりがなければ、自分の設定ファイルにこの2行がないか確認してください。
Business・Enterpriseのワークスペースでは、管理者が開始時のモデル・推論レベル・速度とFast modeの可否を決めます。ヘルプによると、Fast modeを使える設定は初期状態で有効です。なお、Pro 500で使えるAstra Ultrafastは、プランの枠を標準の8倍の速さで消費します。
5. サブエージェントを制限する
ローカルで動くCodexの現在の版は、直接頼んだときか、AGENTS.mdやスキルの指示が求めたときに作業をサブエージェントへ分けます。AGENTS.mdに並列作業の指示を書いたままにしていないか、一度確かめておくと安心です。止めたい場合は、設定でagents.enabledをfalseにすると無効になります。同時に動く数だけ減らしたいときは、agents.max_concurrent_threads_per_sessionで上限を指定してください。
推論レベルの6段階の違いと、Astra・GPT-6.1 Sol・Lunaで選べる範囲、作業ごとにどのレベルから始めるかは、次の記事で確認できます。
使い方で減らす:文脈を軽くしてトークンを節約する
入力トークンには、今回の指示に加えて、会話の履歴、AGENTS.md、接続しているMCPサーバーの説明、読み込んだファイルが毎回含まれます。Codex料金ページの「利用枠を長持ちさせるには」とヘルプの案内から、使い方で減らせる項目を並べました。
- 指示は正確に、渡す資料は関係する分だけにする。料金ページは、不要な文脈を削り、関係するファイルだけを渡し、できれば対象や日付の範囲を絞るよう勧めています。リポジトリ全体を読ませる前に、どのフォルダの話かを伝えてください。
- 出力の形と長さを先に決める。誰向けか、どんな形式で、どれくらいの長さかを指定し、必須の作業と任意の改善を分けて頼むと、余計な出力が減ります。
- AGENTS.mdを小さくし、使わないMCPサーバーを無効にする。大きなプロジェクトではAGENTS.mdをフォルダごとに分けて置くと、読み込む文脈を調整できます。読み込む上限は設定の
project_doc_max_bytesで決まります。MCPサーバーは1つ増えるごとにメッセージへ文脈を足すので、使わないときは無効にしてください。 - 会話が長くなったら
/compactか新しいチャットにする。/statusで文脈の使用量と利用上限を確認でき、/compactで現在のチャットの文脈を圧縮できます。自動圧縮のしきい値は設定のmodel_auto_compact_token_limitで変えられます。別の作業を始めるときは、新しいチャットにしたほうが入力トークンは減ります。 - 画像生成は控えめにする。料金ページによると、画像生成は同じようなターンより平均で3〜5倍速く枠を使います(画質とサイズによる)。
- 大きな作業の前に残量を見る。ヘルプは、大きなタスクの前に設定の利用状況画面で残量・時間枠・リセット時刻を確かめ、モデルと推論レベルを先に決め、結果を見てから上げるよう勧めています。料金ページも、1〜2週間ごとに利用状況を見て自分のペースをつかむよう案内しています。
同じ文脈を続けて送った分は「キャッシュ済み入力」として安い単価で計算されます。Astraは通常の10分の1の25クレジット、GPT-6.1 Solは20分の1の2.5クレジットです。同じチャットで続けるターンは、履歴の長さから想像するほど重くはなりません。それでも履歴が積み上がるほど毎回の入力は増えるので、作業の区切りで/compactか新しいチャットに切り替えることを筆者はおすすめします。
上限に達したときの選択肢
作業の途中で上限に達しても、そのターンは適正利用の範囲で最後まで続けられます。次のターンからは、アカウントに表示される選択肢から選んでください。公式ヘルプと料金ページの記述をまとめると、次の表のとおりです。
| 選択肢 | 内容と条件 |
|---|---|
| 待つ | 設定の利用状況画面で、5時間と週のどちらの枠に達したかとリセット時刻を確かめる。5時間の枠だけが尽きた場合も、週の枠の残りに関係なくリセットまで待つ |
| 保存済みリセット | アカウントに保存されたリセット。デスクトップアプリの設定の利用状況画面で「1 reset available」などを選んで使う。5時間と週の枠を戻し、週のリセット日も変わる。有効期限がある |
| 購入するリセット | 対象の個人向けPlus・Proで、アカウントと請求先の国によって買える。枠が残っていてもすぐ戻り、保存はできない。週の区切りが前倒しになる |
| クレジット購入 | Plus・Proで上限に達すると「クレジットを追加」が表示される。プランはそのままで、含まれる枠を使い切った後の分をクレジットで払う。有効期限は購入から12か月で、自動リロードも設定できる |
| Luna Reserve | 一部の個人向けPlus・Proだけ。通常の枠を使い切った後、GPT-5.6 Lunaに限って別の枠で続けられる。通常の枠は戻らず、Astraも使えない |
| APIキーで続ける | 自分のAPIキーでローカルのチャットを追加で動かせる。料金はAPIの標準料金で、プランの枠とは別にかかる |
| モデルを切り替える | 共有の利用枠は戻らない(ヘルプに明記) |
クレジットの購入額や価格は、公式ヘルプでもアカウント・地域・プランによって変わるとされ、購入画面で表示されます。残高と使用量の履歴は、設定の利用状況画面かCodexアプリの利用状況と請求の画面で確認できます。
Pro 200は、2026年9月29日に利用枠の引き下げが発表されました。条件を満たす既存の契約者も、旧枠を使えるのは10月29日までです。既存契約の扱いと、Pro 100・Pro 500・Plusとの比較は次の記事にまとめました。
Astra公開直後の2026年9月3日と4日には、対象の既存のPlus・Pro・Business契約者に保存済みリセットが1日1回ずつ配られました。9月7日には、対象のPlus・Pro・Businessの枠を戻す自動リセットも行われています。9月12日には、OpenAIでCodexとChatGPTを担当するTibo氏のXアカウント(@thsottiaux)に、品質問題に伴うリセットの投稿がありました。一方でヘルプには、今後のリセットは保証されないと明記されています。リセットを前提に枠を使い切る計画は立てず、配られたら設定の利用状況画面で適用されたかを確かめる使い方が、筆者のおすすめです。
Chatの「GPT-6 Pro」とは別の枠
ChatGPTのChatで選べるGPT-6 ProはAstraで動いていますが、メッセージの上限はWork・Codexの共有枠とは別に数えられます。対象はPro 100・Pro 200・Business・Enterpriseです。PlusでAstraを使えるのは、WorkとCodexの中だけです。
Work・Codexと同じ枠を使う入口はほかにもあります。2026年9月17日に公開されたChatGPT for Wordもその一つで、Wordから使った分がどの枠から引かれるかは次の記事で解説しています。
今日やること
まず設定を3つ見直してください。推論レベルを低め(アプリではLight、CLIではlow)かMediumにする、Fast modeを切る、使っていないMCPサーバーを無効にする、の3つです。「なぜか減りが早い」と感じる場合の多くは、この3つで説明がつくと筆者は見ています。そのうえで、日常の作業はGPT-6.1 SolやLunaに任せ、Astraは難しい調査や大きな改修のときだけ、残量を確かめてから使います。上限に達したら、設定の利用状況画面にリセットの表示がないかを見てから、クレジットか待機かを選ぶとよいでしょう。
利用枠・単価・リセットの条件は変わりやすく、この記事は2026年10月1日時点の公式資料に基づいています。数字が合わないときは、設定の利用状況画面の表示を優先してください。問い合わせる場合は、使ったモデル・推論レベル・Fast modeの設定と、日時・タイムゾーンを添えるとOpenAIサポートが調べやすくなります。
Codexで作ったサイトを公開したい人へ
利用枠を節約しながらCodexでWebページやツールを作ったら、次に決めるのは公開する場所です。次の記事では、GitHub PagesやCloudflare Pagesなど無料の置き場所と、フォームや独自ドメインのメールが要る場合のレンタルサーバーの違いを、手順と費用で比べています。
Codexの利用枠が合わないと感じたら、ほかのコーディング用AIと比べてみる方法もあります。Codex・GitHub Copilot・Cursorの無料で試せる範囲と、個人向け有料プランの料金は次の記事で整理しました。