PR|この記事にはアフィリエイト広告(A8.net)が含まれます。
ブログの記事をAIの学習に使われたくない。けれど、Googlebotのように検索とAI学習を1つのクローラーで兼ねている相手をブロックすると、検索結果からも消えてしまう。サイト運営者が抱えてきたこの二択に対して、Cloudflareは2026年9月15日、検索用のクロールは許可したままAI学習への利用だけを断る新しい設定「Disallow AI Training」の提供を始めました。
Cloudflareの公式ブログによると、この設定は無料プランを含むすべてのプランで使えます。ただし、学習を断る部分はrobots.txtに書き込んだ希望を各社のクローラーが守ることで成り立つ仕組みです。GoogleとAppleはrobots.txtでの学習拒否にすでに対応していますが、Microsoft(Bing)のrobots.txtへの対応は2027年初めが目標で、それまではこの設定だけでは、robots.txtを通じてBingに学習拒否が自動では伝わりません。この記事では、変わった点、4つの選択肢で何が起きるか、設定場所、以前から設定していた人への影響、検索順位やAIの回答への影響、Cloudflareを使っていない場合の考え方を順に整理します。
- 発表と提供開始は2026年9月15日。公式ブログには、無料プランを含むすべてのプランで使えると書かれています。
- 「Disallow AI Training」はAI学習(Training)の設定にだけある選択肢です。Googlebot・Applebot・Bingbotのように、Cloudflareが「説明責任がある」と分類した複合用途クローラー(検索と学習を兼ねるクローラー)は検索のために通し、それ以外の学習用クローラーはブロックします。
- 同じ日から「Block」の意味が変わり、GooglebotやApplebotも止まるようになりました。検索に残りたい場合、AI学習の設定で「Block」を選ぶと検索にも影響します。
- 学習の拒否は、robots.txtで伝える希望をクローラー側が守ることと、希望を無視するクローラーをCloudflareが見分けてブロックすることで成り立っています。学習を完全に防げると保証する仕組みではありません。
情報確認日:2026年9月19日。Cloudflareの日本語プレスリリース、Cloudflare公式ブログ2本、Googleのクローラー一覧を読んでまとめた解説です。

PR 生成AIを仕事で使う力をまとめて学ぶなら、DMM 生成AI CAMP 学び放題(職種別11コースが月額14,800円(税込16,280円)で学び放題)。先に仕組み・料金・解約条件の解説を読むこともできます。


2026年9月15日に何が変わった?
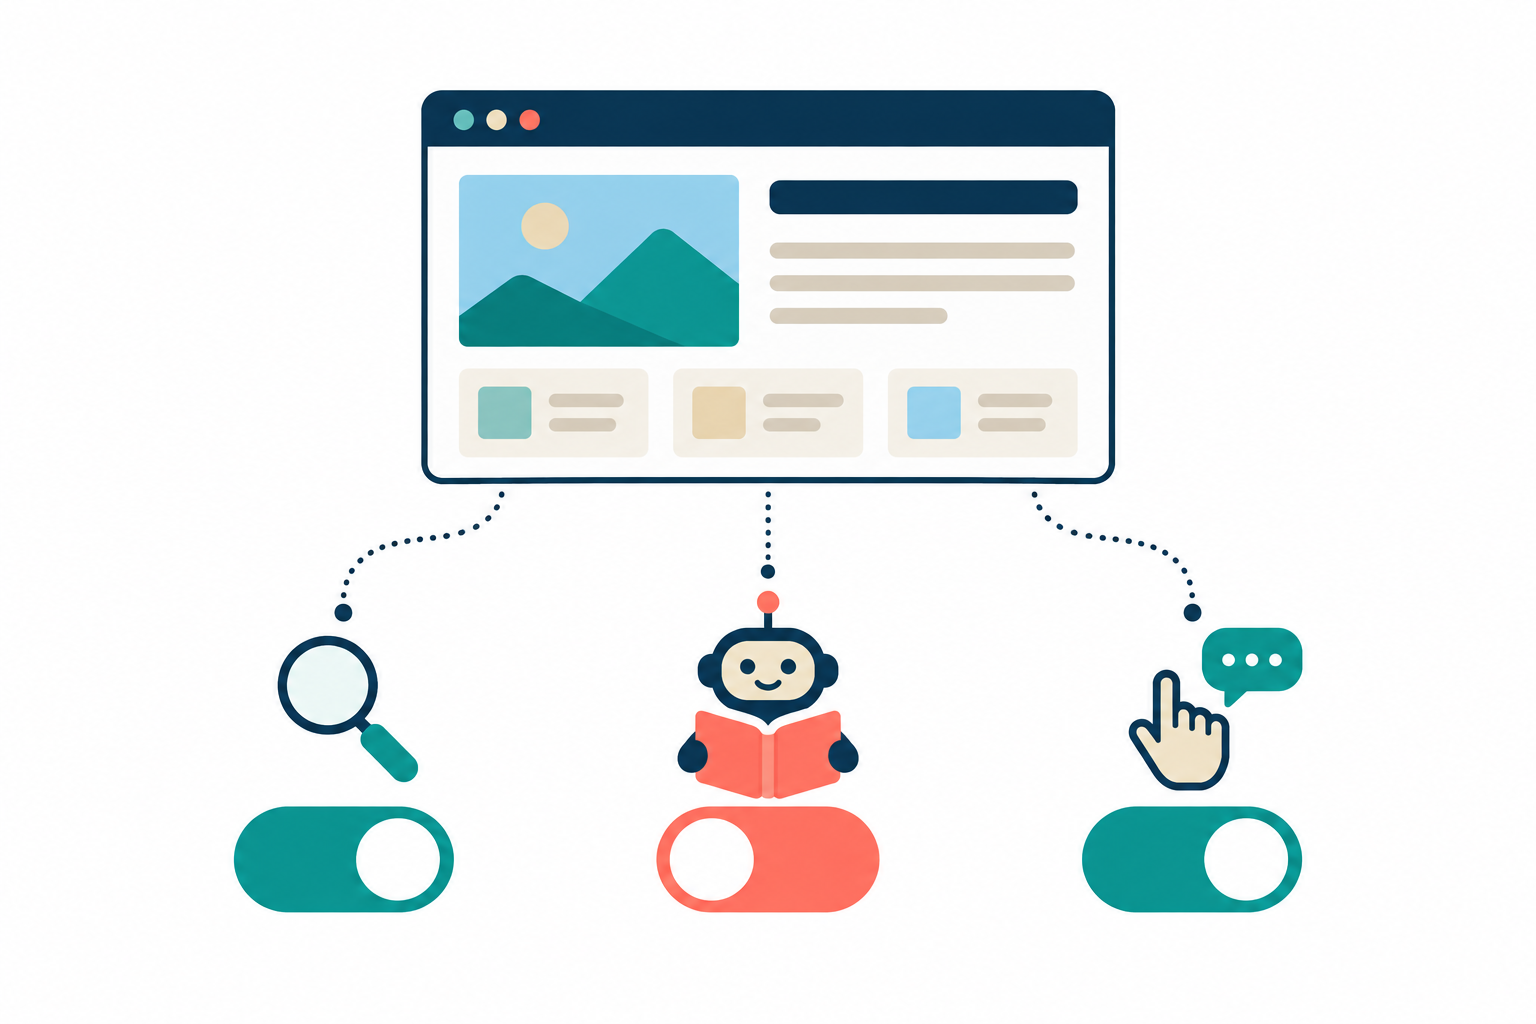
これまでCloudflareには、AIボットをまとめて止める「Block AI Bots(AIボットをブロック)」というスイッチがありました。9月15日のプレスリリースでは、このスイッチを「検索用」「AIトレーニング用」「AIエージェント用」の3つの独立した設定に置き換えると発表しています。3つの設定そのものは2026年7月1日から提供されていたもので(Bot Preference Syncの公式ブログに記載)、9月15日に旧スイッチを廃止し、3つの設定に一本化する形です。公式ブログでの定義は次のとおりです。
- Search(検索):検索用のインデックスを作るためのクロール
- Training(AI学習):AIモデルの学習や追加学習のためのクロール
- Agent(AIエージェント):人の依頼を受けてページを見に来るAI。チャットAIがページを取りに来るボットや、ブラウザを操作するエージェントなど
難しかったのは、1つのクローラーが検索と学習の両方を担う「複合用途クローラー」の扱いです。プレスリリースによると、複合用途クローラーはCloudflareのネットワーク上で確認されたクローラーの通信の36.6%を占める最大のカテゴリです。一方で、Cloudflare上のサイトのうち検索クローラーをブロックしているのは1%未満、AI学習を制限しているのは17%だとCloudflareは説明しています。学習だけを断りたいサイトは多いのに、複合用途クローラーを止めると検索からも消える、という状態が続いていました。
そこで加わったのが、AI学習の設定にある「Disallow AI Training」です。名前は、robots.txtに書き込む「Disallow:」の指定から来ています。あわせて、AIクローラー向けのrobots.txtを自動で用意していた「Managed Robots.txt」を「Bot Preference Sync」に置き換えることも発表されました。Bot Preference Syncは、Cloudflareで選んだ検索・AI学習・AIエージェントの設定を、対応するクローラー向けの指定としてrobots.txtに反映する機能です。
無料プランでも使える?
使えます。日本語のプレスリリースには対象プランの記載がありませんが、同じ日の公式ブログの末尾に「すべての顧客が、すべてのプランで使える」と書かれています。Bot Preference Syncを紹介した公式ブログ(2026年8月21日公開)にも、無料プランからEnterpriseまで利用できると書かれています。
前提として、自分のサイトのドメインをCloudflareに登録している必要があります。設定はドメイン(Cloudflareでいう「ゾーン」)単位です。Cloudflareをネームサーバー(DNS)としてだけ使い、サイトへの通信をCloudflare経由にしていない場合にこの設定が働くかどうかは、今回読んだ公式資料には書かれていませんでした。
4つの選択肢を選ぶと、検索・AI学習・AIエージェントに何が起きる?
3つの設定には、それぞれ次の選択肢があります。「Disallow AI Training」を選べるのはAI学習の設定だけです。表の内容は公式ブログの定義を日本語でまとめたものです。
| 選択肢 | 選べる設定 | 何が起きるか | 検索への影響 |
|---|---|---|---|
| Allow(許可) | 検索・AI学習・AIエージェント | その用途のクローラーを通す。ほかの設定やWAFのルールでブロックしている場合を除く | なし |
| Disallow AI Training | AI学習だけ | Bot Preference Syncを通じて、robots.txtに「学習に使わないで」という希望を書き込む。説明責任があると分類された複合用途クローラーは検索のために通し、それ以外の学習用クローラーはブロックする | 説明責任のある複合用途クローラー(Googlebot・Applebot・Bingbot)は検索のために通る |
| Block on pages with ads | 検索・AI学習・AIエージェント | 広告を表示していると検出されたページだけでブロックする。複合用途クローラーも対象 | AI学習の設定で選ぶと、広告のあるページではGooglebotなども止まる |
| Block(ブロック) | 検索・AI学習・AIエージェント | すべてのページでブロックする。複合用途クローラーも対象 | AI学習の設定で選ぶと、Googlebot・Applebot・Bingbotも止まり、検索にも影響する |
「Disallow AI Training」でブロックされる学習用クローラーには、Amazon・Anthropic・Meta・OpenAIが運営する学習専用のクローラーも含まれます。これらの会社は検索用と学習用のクローラーを分けているため、学習用を止めても検索には影響しない、と公式ブログは説明しています。
広告を表示しているブログで特に注意したいのは「Block on pages with ads」です。9月15日から、この選択肢も複合用途クローラーに適用されるようになりました。広告をほぼ全ページに表示しているブログがAI学習の設定でこれを選ぶと、ほとんどのページでGooglebotが止まる可能性があります。なお、「広告のあるページだけ学習を断る」という選択肢はありません。広告を出しているページの一覧は大きく、頻繁に変わるため、robots.txtに書き出せないからだと公式ブログは説明しています。
どこで設定する?
公式ブログによると、3つの設定はドメイン(ゾーン)の「Security Settings(セキュリティ設定)」で変更します。公式ブログの説明をもとにした流れは次のとおりです。ダッシュボードを日本語で表示したときの項目名は、2026年9月19日時点で公式資料から確認できなかったため、英語の表記で書いています。手順の後半にある確認は、筆者が加えたものです。
- Cloudflareのダッシュボードにログインし、アカウントと対象のドメインを選ぶ
- ドメインのSecurity(セキュリティ)の設定画面を開き、AIボットに関する設定を探す
- Training(AI学習)を「Disallow AI Training」にする
- Search(検索)が「Allow」になっているか、Agent(AIエージェント)が意図した選択肢になっているかを確かめる
- Bot Preference Syncがオンになっているかを確かめる
- ブラウザで自分のサイトの「/robots.txt」を開き、Cloudflareが追加した記述があるかを見る
Bot Preference Syncの公式ブログによると、すでにrobots.txtがあるサイトでは、Cloudflareの記述が既存の内容の前に追加され、もとの指定は残ります。公式ブログの例では「# BEGIN Cloudflare Bot Preference Sync」から始まるまとまりの中に、学習を断るクローラーの名前と「Disallow: /」が並んでいます。ただしこの例は短く省略したもので、実際に書き込まれるクローラーの一覧はCloudflareが定期的に更新すると説明されています。
Bot Preference Syncはいつでもオン・オフでき、新しく登録する顧客では既定でオンです。特定の会社にだけ例外を認めるような細かいルールは読み取らないため、そうした運用をしている場合は同期をオフにして、robots.txtを自分で整える選択肢も用意されています。
以前から「Block AI Bots」をオンにしていた場合はどうなる?
公式ブログは「ほとんどの場合、何もする必要はない。今の設定は自動で引き継がれる」と書いています。細かい3つの設定を使っていなかったドメインは、旧「Block AI Bots」の状態に応じて次のように移行されると公式ブログは説明しています。
| 以前のBlock AI Bots | 検索 | AI学習 | AIエージェント |
|---|---|---|---|
| オフ(未選択) | Allow | Allow | Allow |
| Block | Allow | Disallow AI Training | Block on pages with ads |
| Block on pages with ads | Allow | Disallow AI Training | Block on pages with ads |
見落としやすいのはAIエージェントの列です。3つの設定を使わずにBlock AI Botsをオンにしていたドメインは、AI学習だけでなく、AIエージェントも「広告のあるページではブロック」に移行されます。チャットAIが利用者の依頼で自分のページを読みに来ることまで止めたくない場合は、移行後の設定を一度確かめておくと安心です。
すでに3つの設定を個別に選んでいたドメインは、選んでいた効果を保つように移行されます。AI学習で「Block」または「Block on pages with ads」を選んでいた場合は「Disallow AI Training」に変わります。検索とAIエージェントの設定はそのまま引き継がれます。旧Managed Robots.txtを使っていた人は新しい仕組みに移行され、Bot Preference Syncの公式ブログでは、設定を確認するよう案内が表示されると説明されています。
逆に、複合用途クローラーごと止めたい場合は、自分で「Block」を選び直す必要があります。公式ブログは、Blockを選ぶとApplebot・Bingbot・Googlebotがサイトに来なくなり、検索も含めて止まると明記しています。
これから登録するドメインの推奨設定
9月15日以降に新しくドメインを登録すると、広告で収益を得ているかどうかで2種類の推奨設定が提案されます。公式ブログには、登録の途中で「I monetize pages that serve ads(広告を表示するページで収益を得ている)」を選んだ場合の画面が載っています。どちらも登録中や登録後にいつでも変更できます。
| 設定 | 広告で収益を得ていないサイト | 広告で収益を得ているサイト |
|---|---|---|
| Bot Preference Sync | オン | オン |
| 検索 | Allow | Allow |
| AI学習 | Allow | Disallow AI Training |
| AIエージェント | Allow | Block on pages with ads |
広告収益のサイトが厳しめになっている理由について、公式ブログは、広告収入は人が実際にページを見ることで生まれるのに対し、AI学習はその訪問を回答に置き換え、エージェントは広告を見る人がいない状態でページを取得するためだと説明しています。
検索順位やAIの回答での表示は変わる?
ここは「検索順位」「検索結果のAI要約」「AIアプリでの参照」を分けて考える必要があります。Disallow AI Trainingが扱うのはAI学習で、AI要約は別の設定になるためです。
検索順位への影響
Googleは自社のクローラー一覧で、Google-Extendedの指定がGoogle検索への登録に影響したり、ランキングの要素として使われたりすることはないと明記しています。Appleは学習を断っても検索順位に影響しないと表明し、MicrosoftはNOARCHIVEを使っても検索順位に影響しないと表明している、とCloudflareの公式ブログは伝えています。Cloudflareが「説明責任がある」と認める条件にも、学習を断っても従来の検索結果に影響しないと公に示すことが含まれています。
検索結果のAI要約は別の設定になる
Cloudflareは、AI学習とAI要約を別の問題として扱い、AI要約の管理を次の課題に挙げています。検索結果に表示されるAIの要約から外れたい場合は、2026年9月時点では各社の仕組みで個別に設定します。公式ブログによると、Googleはサイト運営者向けの管理画面に、サイトの内容を生成AIの検索結果から除外する切り替えを用意しています。Appleは、ページのHTMLに書く「nosnippet」の指定で要約についての希望を伝えられます。Cloudflareは、どの程度の内容を要約に含めるかを一か所で管理できるようにすることを、2027年初め(プレスリリースの表現では「来年初め」)までの目標にしています。
Geminiアプリでの参照には影響がある
GooglebotとGoogle-Extendedの関係も押さえておきたいところです。Googleの説明では、Google-Extendedは専用のクローラーではなく、robots.txtで使う「トークン(指定用の名前)」です。クロール自体は既存のGoogleのクローラーが行い、Google-Extendedの指定で、集めた内容を何に使ってよいかを管理します。対象は、次世代のGeminiモデルの学習と、Geminiアプリでのグラウンディング(事実の確かさや関連性を高めるために、指示を受けた時点で検索インデックスからモデルに内容を渡すこと)などです。
Googleの説明に沿えば、Google-Extendedを断ってもGoogle検索への登録には影響しない一方で、Geminiアプリでのグラウンディングにも自分のサイトの内容が使われなくなります。Cloudflareの公式ブログは、Googleに対して学習を断る方法としてGoogle-Extendedの指定を挙げています。自分のrobots.txtにGoogle-Extendedの行が書き込まれたかどうかは、設定後に確かめられます。
AIエージェントを止めると、チャットAIが読みに来られない
AIエージェントの設定は、利用者の依頼でチャットAIがページを取りに来るボットなどが対象です。「Block」にすると、チャットAIが利用者の依頼で自分のページを読みに来ても、Cloudflareがそのアクセスをブロックします。AIの回答の中で自分の記事が紹介されることを重視するか、広告を見る人の訪問を重視するかで選び方が変わる設定です。
Google・Apple・Microsoftのクローラーは本当に守る?
Cloudflareは、次の4つを満たしているか、期限を決めて満たすと約束したクローラーの運営会社を「説明責任がある(Accountable)」と分類しています。
- robots.txtなどで、AI学習を断る方法を用意している
- 検索結果のAI要約を断る方法を用意している
- どのページが学習に使われたか、検索でどう表示されたかをURL単位で確認できる
- 学習を断っても従来の検索結果に影響しないと公に示している
Apple・Google・Microsoftはこの分類に入っています。検索用と学習用のクローラーを分けているAmazon・Anthropic・Meta・OpenAIの該当クローラーも説明責任があると分類されていますが、こちらは学習用クローラーが分かれているため、Disallow AI Trainingでは学習用のほうがブロックされます。ただし、2026年9月15日の時点で3社ともすべてがそろっているわけではなく、開発中の機能には期限付きの約束が含まれます。公式ブログに書かれた各社の状況を表にまとめます。
| 会社(クローラー) | AI学習を断る方法 | AI要約についての希望の伝え方 | まだ途中のこと |
|---|---|---|---|
| Google(Googlebot) | robots.txtでGoogle-Extendedを「Disallow」にする | サイト運営者向け管理画面の切り替えで、生成AIの検索結果から除外 | Google-Extendedに関するURL単位の確認ツールを追加予定 |
| Apple(Applebot) | robots.txtでApplebot-Extendedを「Disallow」にする | ページHTMLの「nosnippet」の指定 | URL単位の確認ツールは未提供。2027年の提供に向けて準備中 |
| Microsoft(Bingbot) | NOARCHIVEのメタタグ(2026年9月15日時点)。robots.txtでの学習拒否は2027年初めの対応が目標 | 公式ブログに具体的な方法の記載なし(Webmaster Toolsで細かな制御ができると説明) | robots.txtでの学習拒否への対応 |
Bingについては条件付きです。公式ブログは、Microsoftの対応が始まるまで、Disallow AI Trainingを選んでもrobots.txtを通じてBingに学習拒否が自動では伝わらないと書いています。Microsoftの対応が始まるまでの間にBingの学習を断りたい場合は、NOARCHIVEのメタタグに加えて、Bingのツール(Block URLsやContent Removal)を使う方法が案内されています。
「本当に守るか」を外から確かめる手段として、Cloudflareは説明責任のある運営会社が用意している管理機能・透明性・レポートの状況を、Cloudflare Radarで公開して追跡すると説明しています。守られることを前提にした仕組みである以上、発表された約束がそのとおりに実行されるかは、今後の公開情報で確かめていく部分です。
Cloudflareを使っていないブログはどうすればいい?
Cloudflareを使っていなくても、robots.txtで学習を断る希望を伝えることはできます。公式資料で確認できた範囲では、GoogleとAppleに対して次のように書けます。
User-agent: Google-Extended
Disallow: /

User-agent: Applebot-Extended
Disallow: /
この書き方は、Googleのクローラー一覧にあるGoogle-Extendedの記述例と、Cloudflare公式ブログのAppleについての説明をもとにした例です。Bingについては、前の章のとおり、robots.txtでの対応が始まるまではNOARCHIVEのメタタグが手段として紹介されています。Amazon・Anthropic・Meta・OpenAIは学習用のクローラーを分けていますが、それぞれの名前と扱いは各社の公式ページで確かめてから書いてください。
ただし、robots.txtはあくまで希望を伝えるものです。Cloudflareの公式ブログも、robots.txtの指定だけでは、誰がなぜクロールしているかを見分けることも、指定を無視するクローラーを止めることもできないと書いています。Cloudflareの新しい設定は、robots.txtで希望を伝えるのに加えて、説明責任のある複合用途クローラー以外の学習用クローラーをネットワークの段階でブロックする点が違います。
どの組み合わせを選べばいい?(筆者の提案)
ここからは筆者の提案です。個人ブログでCloudflareを使っている場合、検索は「Allow」のまま、AI学習は学習に使われたくないなら「Disallow AI Training」、使われてもかまわないなら「Allow」が基本になると考えています。AI学習で「Block」や「Block on pages with ads」を選ぶのは、検索から外れてもよい場合に限ったほうが安全です。
迷いやすいのはAIエージェントです。AdSenseなどの広告で収益を得ているブログには、Cloudflareは「広告のあるページではブロック」を推奨しています。一方で、チャットAIの回答の中で記事を紹介されることを流入の入口として期待するなら、「Allow」のままにする考え方もあります。どちらが自分のブログに合うかは、アクセス解析で検索とAIサービスからの流入を見ながら判断するのが現実的だと筆者は見ています。
設定を変えたら、自分のサイトの/robots.txtを開いて、Cloudflareが追加した記述と、もともと書いていた指定の両方が残っているかを確かめておくと安心です。
- ダッシュボードを日本語で表示したときの項目名と、9月15日以降の正確なメニューの階層。Cloudflareの開発者ドキュメントは、この日時点でDisallow AI Trainingの説明がまだ載っていませんでした。
- 旧Managed Robots.txtを使っていなかった既存のドメインで、Bot Preference Syncが最初からオンになるかどうか。
- Cloudflareを経由しない(DNSだけ使う)構成でこの設定が働くかどうか。
- Bot Preference Syncが実際にrobots.txtへ書き込むクローラーの一覧と、同期をオフにした場合に学習拒否の希望がどう伝わるか。
- Googleの「生成AIの検索結果から除外する切り替え」の具体的な場所と名称。
AIに学習されることへの備えとは別に、記事づくりや画像制作にAIを取り入れる方法を体系的に学びたい場合は、講座を検討する方法もあります。
DMM 生成AI CAMP 学び放題:職種別11コースを月額で好きなだけ学べるスクール
DMM 生成AI CAMP 学び放題は、生成AIデザイン・動画制作・AIアプリ開発・マーケティングなど職種別の11コース(約1,000レッスン)を、月額14,800円(税込16,280円)で好きなだけ学べるサブスク型のスクールです。入会金は0円で、月額プランなら最低契約期間の縛りがありません。
- コースをまたいで学べる。画像づくりから始めて動画編集やClaude Codeへ進むなど、目的が変わっても追加料金なしで学び直せます。
- 一人で止まりにくい。週1回×3か月のライブゼミで課題の公開添削を受けられ、分からないことは24時間対応のAIチューターに質問できます。
- 学んだ先の場がある。受講生限定のコミュニティや会員限定ワークショップ、DMMグループを含む企業の実案件コンペに参加できます。
仕組み・料金・自動更新や解約の条件は、DMM 生成AI CAMP 学び放題の解説記事で、向いている人・向かない人まで確認できます。
申込み前の確認:どのプランも自動更新で、更新を止めるには契約満了日の1日前までに退会申請が必要です。ChatGPT Plus等の外部サービス利用料・API利用料は受講料に含まれません。料金・条件は2026年9月15日に公式サイトで確認したものです。
先に内容を聞いてから決めたい方は、無料セミナーを予約できます(セミナーに参加しなくても入会できます)。