PR|この記事にはアフィリエイト広告(A8.net)が含まれます。
CodexのCLIで /fast というコマンドを見つけたり、デスクトップアプリの設定に速度の項目があったりして、オンにしてよいのか迷っていませんか。利用枠の減りが急に早くなり、原因を探している人もいるかもしれません。
この記事では、Fast modeの仕組みと利用枠の消費の増え方、オン・オフの切り替え方、使う場面と使わない場面を、OpenAIの公式ドキュメントをもとに整理します。
- Fast modeは、対応モデルの応答を速くする代わりに、利用枠を多く使う設定です。プランに含まれる利用枠は標準(Standard)の2.5倍、購入したクレジットは2倍のペースで減ります。
- ChatGPTでサインインしたデスクトップアプリ・CLI・IDE拡張で使えます。料金ページの機能表ではPlus・Pro・Business・Enterprise・Eduが対象で、FreeとGoの説明は標準の速度だけです。
- CLIでは
/fastを1回入力するとオン、もう1回でオフです。デスクトップアプリでは、Powerの設定のAdvancedで速度を選びます。
Fast modeを切り替える前に、自分の利用枠があと何%残っていて、いつリセットされるのかを見ておくと判断しやすくなります。使用量の確認場所は次の記事にまとめました。
利用枠が足りなくなるたびにCodexへ細かな修正まで頼んでいる人は、自分でコードを読んで直せる基礎を身につけておくと、頼む量そのものを減らせます。Web制作やAI活用を学べるデイトラの料金と講座の選び方は、次の記事で紹介しています。
情報確認日:2026年10月18日。OpenAIのCodex公式ドキュメントと公式ヘルプをまとめた解説です。
CodexのFast modeとは?速度を上げる代わりに利用枠を多く使う設定
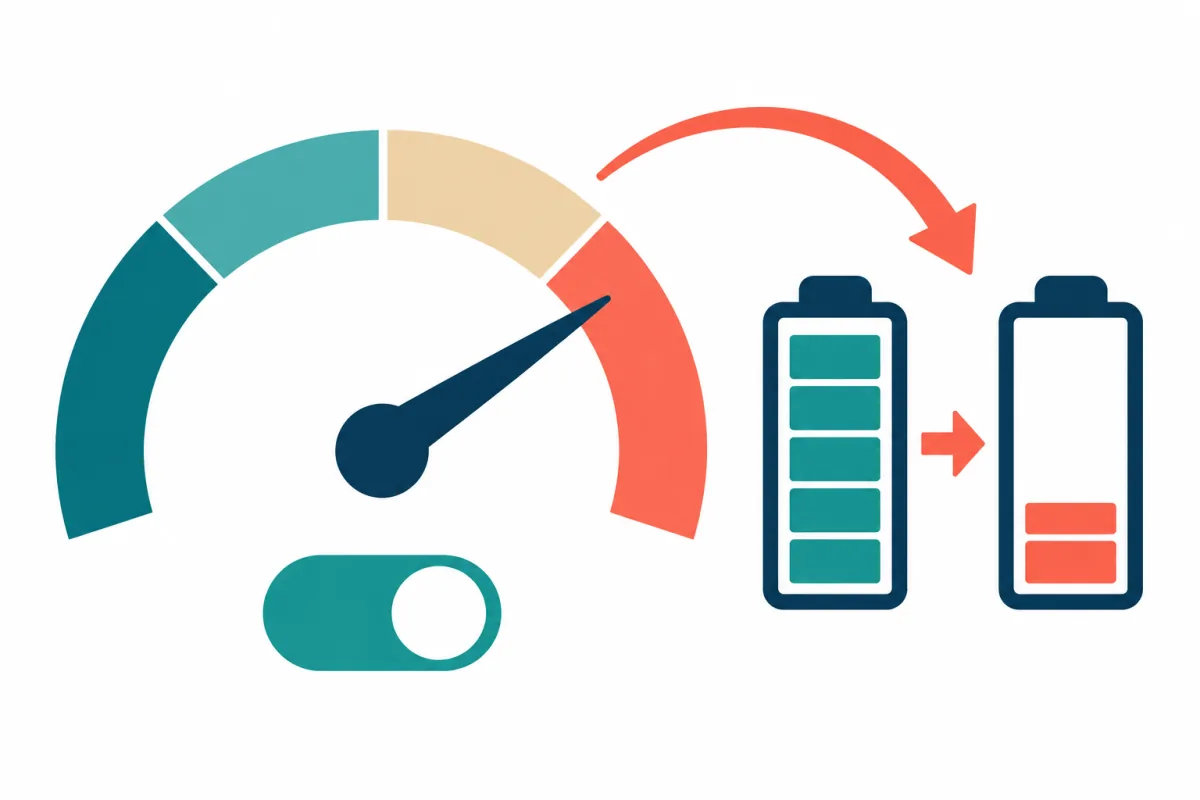
Fast modeは、Codexでモデルの応答を速くする代わりに、利用枠を通常より多く使う設定です。公式ドキュメントの「Speed」のページでは、使用量を多く払う代わりにモデルの速度を上げられる機能として説明されています。
対応モデルとして挙がっているのは、GPT-6.1 Sol、GPT-6 Astra、GPT-6 Sol、GPT-6 Lunaです。ただし「提供されている場合」という条件が付いており、使っているモデルやアカウントによっては選べないこともあります。
どれだけ速くなるかについて、公式ドキュメントに数字があるのはGPT-5.6だけで、速度は1.5倍とされています。GPT-6系のモデルで何倍速くなるかは、2026年10月18日時点の公式資料では未記載です。
OpenAIのヘルプによると、GPT-6 AstraとGPT-6.1 Solは、既定の速度のままで文字を出す速さが約50%上がっています。この改善を受けるためにFastやUltrafastをオンにする必要はありません。FastとUltrafastは、これとは別の選択肢で、使えるプランと利用枠の減り方もそれぞれ決まっています。
Fast modeで利用枠の消費はどれだけ増える?含まれる枠は2.5倍、購入クレジットは2倍
Fast modeの消費は、同じモデルを標準の速度で使ったときと比べて、プランに含まれる利用枠では2.5倍、購入したクレジットでは2倍です。払い方によって倍率が違うので、表で分けて確認します。
| 速度の設定 | プランに含まれる利用枠 | 購入したクレジット(Enterpriseの従量課金も同じ) |
|---|---|---|
| Standard(標準) | 1倍 | 1倍 |
| Fast | 2.5倍 | 2倍 |
| Ultrafast(GPT-6 Astra・GPT-6.1 Sol) | 8倍 | 6倍 |
この倍率は利用枠の減り方を表す数字で、速度が2.5倍になるという意味ではありません。速さの倍率と消費の倍率は別に決まっています。
Plusの5時間の目安に当てはめると
Codexの料金ページでは、Plusで5時間あたりに送れるローカルメッセージの目安が、GPT-6.1 Solで15〜160件と書かれています。すべてFast modeで送ると枠が2.5倍の速さで減るため、筆者の計算では5時間あたりおよそ6〜64件です。
この目安は固定の上限とは違い、作業の大きさや文脈の量、推論レベル、ツールの使い方で大きく変わります。実際の残りは使用量の画面かCLIの /status で確かめてください。Proは2026年10月18日時点で5時間の上限がありません。料金ページには、プラン全般について週の上限が適用される場合があるとも書かれています。
クレジットで払う場合の単価
利用枠を使い切ってクレジットで払う場合は、標準の単価の2倍になります。たとえばGPT-6.1 Solの出力は、標準の速度で100万トークンあたり250クレジットです。Fast modeでは、筆者の計算で100万トークンあたり500クレジットになります。トークンはモデルが文章を処理する単位で、消費には入力と出力の両方が含まれます。
クレジットの買い方と有効期限は、次の記事で手順ごとに説明しました。
Fast mode以外でCodexの利用枠の消費を抑える方法と、上限に達したときの選択肢は、次の記事で確認できます。
枠を使い切ったあとにリセットを買う方法は、Codexの利用枠リセットを買うとは?クレジット・保存済みリセットとの違いにまとめています。
Fast modeを使えるプランと画面は?Ultrafastとの違いも
Fast modeは、ChatGPTのアカウントでサインインしたデスクトップアプリ、Codex CLI、IDE拡張で使えます。Codexの料金ページの機能表では、Plus・Pro・Business・Enterprise・EduにFast modeが含まれています。
| 速度の設定 | 使えるプラン | 対応モデル | 含まれる枠の消費 | 向いている人 |
|---|---|---|---|---|
| Standard | Free・Goを含む全プラン(Free・GoはGPT-6 Luna、段階提供) | 各プランで使えるモデル | 1倍 | 利用枠を長持ちさせたい人 |
| Fast | Plus・Pro・Business・Enterprise・Edu | GPT-6.1 Sol・GPT-6 Astra・GPT-6 Sol・GPT-6 Luna(提供されている場合) | 2.5倍 | 待ち時間を減らしたい作業がはっきりしている人 |
| Ultrafast | Pro $500と対象のEnterprise・Edu | GPT-6 Astra・GPT-6.1 Sol | 8倍 | Pro $500で、速さを最優先する作業がある人 |
FreeとGoは、料金ページのプラン説明が「標準の速度のGPT-6 Luna(デスクトップアプリ、段階提供)」となっていて、機能表にもFreeとGoの列がありません。FreeとGoでFast modeが使えないと明記した文は見つかりませんでしたが、2026年10月18日時点の公式資料にはFreeとGoでFast modeを使える記載もありません。
Ultrafastは、Fastよりさらに速さを優先する別の設定です。PlusやPro $100・$200、Businessでは、クレジットを買ってもUltrafastは使えません(公式ドキュメントは「提供開始時点では」と書いています)。Pro $500では、まずプランに含まれる枠を使い、使い切った後はクレジットから払う仕組みです。
料金ページの機能表ではAPIキーの列にもFast modeの印がありますが、APIキーでCodexを使う場合はAPIのトークン料金で請求され、この記事の倍率は当てはまりません。
Fast modeのオン・オフの切り替え方
Fast modeは、CLIならスラッシュコマンド、毎回オンにしたいなら設定ファイル、デスクトップアプリならPowerの設定から切り替えます。
Codex CLIで切り替える
- Codex CLIを起動し、入力欄に
/fastと入力してEnterを押すと、いま使っているモデルのFast modeがオンになります。 - もう一度
/fastを入力するとオフに戻ります。選んだ状態は保存されます。 - オンかオフかを画面下のフッターで確かめたい場合は、
/statuslineでFast modeの表示を追加します。
使っているモデルがFast modeを提供していない場合、/fast はコマンドの一覧に出てきません。/fast が見つからないときは、/model で対応モデルに切り替えてから試してください。
config.tomlで既定にする
起動するたびにFast modeを使いたい場合は、Codexの設定ファイル config.toml に次の2つを書くと既定にできます。逆に、知らないうちにFast modeがオンになっている場合は、この2つが書かれていないかを確かめてください。
service_tier = "fast"

[features]
fast_mode = true
デスクトップアプリで切り替える
ChatGPTのデスクトップアプリでは、Powerの設定にあるAdvancedを開くと、モデル・推論レベル・速度を個別に選べます。選べる項目はプランやワークスペースの設定で変わります。Advanced内の速度の表示名と、IDE拡張での切り替え手順は、公式ドキュメントに詳しい記載がありません。
Powerの設定にはSmarterとFasterという向きもあります。公式ドキュメントでは、Smarterは「より深い推論」、Fasterは「より速く、低コストな作業」に向けて動かす設定と説明されています。Fasterの方向に動かす操作が、利用枠を多く使うFast modeと同じかどうかは、2026年10月18日時点の公式ドキュメントに書かれていません。Fast modeがオンかどうかは、Advancedの速度の項目で確かめるのが確実だと筆者は考えます。
Fast modeを使う場面・使わない場面
Fast modeは、待ち時間を減らす価値が利用枠の減りより大きいときだけオンにする、というのが筆者の提案です。公式ヘルプによると、Codexは推論やツールの実行、複数の手順に時間を使うため、文字の生成が速くなっても作業全体が目に見えて早く終わるとは限りません。
オンにしてもよい場面(筆者の提案)
- 画面を見ながら短いやり取りを何度も繰り返し、返答を待つ時間がそのまま作業の遅れになるとき
- 締め切りが近く、利用枠よりも時間を優先したいとき
- Proなどで利用枠に余裕があり、リセットまでに使い切らずに終わることが多いとき
オフにしておきたい場面(筆者の提案)
- テストの実行やファイルの読み込みなど、ツールの処理に時間がかかる作業
- 指示を出して別の作業をしている間に終わればよい、長めのタスク
- Plusで5時間や週の上限によく当たる人の普段使い
- クレジットで払っている最中の作業(1トークンあたりの支払いが2倍になる)
速さを求めるなら、Fast modeの前に、モデルを軽いものにしたり推論レベルを下げたりする方法もあります。推論レベルごとの違いと、利用枠を無駄にしない上げ方は次の記事で整理しています。
Fast modeの注意点と、オフのままでよい人
Fast modeの一番の注意点は、CLIで一度オンにすると選んだ状態が保存され、次からもオンのまま使い続けてしまうことです。利用枠が急に早く減ったと感じたら、まず /statusline の表示か config.toml の設定でFast modeがオンになっていないかを確かめてください。
消費の倍率は速さの倍率とは別の数字です。2.5倍の枠を使っても、作業が2.5倍早く終わるとは限りません。GPT-6系のモデルで何倍速くなるかは公式に書かれていないため、自分の作業で試してから使い続けるかを決めることになります。
FreeとGoの人、Plusで上限によく当たる人、作業を任せて待てる人は、オフのままで困る場面は少ないと筆者は考えます。
Codexの上限に何度も当たる人へ
Fast modeをオフにしても上限に何度も当たる人は、小さな修正や確認までCodexに頼んでいることが多いかもしれません。HTMLやCSS、JavaScriptの基礎が分かれば、簡単な直しは自分で済ませられ、Codexへの頼み方も短く具体的になります。
デイトラは、Web制作やWebデザイン、AI活用などの講座を受けられるオンラインスクールです。Codexが書いたコードを自分で読んで直せるようになりたい人は、講座の内容を一度見ておくと、学ぶ順番の参考になります。
- 40講座以上を受けられる、買い切りの学び放題という形です(公式サイトの表記)。
- 登録すると、20以上の無料公開レッスンで講座を体験できます。

講座の内容は2026年10月18日に公式サイトで確認したものです。申し込む前に、料金と最新の内容を公式サイトで確かめてください。
毎日同じ形で繰り返す作業は、Codexに毎回頼む代わりに、n8nやDifyで自動化して自分のサーバーで動かす方法もあります。n8nとDifyを動かすのに必要なシンVPSのプランと、契約期間ごとの総額は次の記事で計算しています。
まとめ
CodexのFast modeは、対応モデルの応答を速くする代わりに、プランに含まれる利用枠を標準の2.5倍、購入したクレジットを2倍のペースで使う設定です。ChatGPTでサインインしたデスクトップアプリ・CLI・IDE拡張で使え、料金ページではPlus・Pro・Business・Enterprise・Eduが対象になっています。
CLIでは /fast でオンとオフを切り替え、選んだ状態は保存されます。待ち時間がそのまま作業の遅れになる場面だけオンにし、普段はオフにしておけば、利用枠を長く使えるでしょう。上限に何度も当たる人は、デイトラで基礎から学ぶ選択肢を次の記事で検討できます。
参考にした公式資料
- ChatGPT Learn(Codex公式ドキュメント):Speed(2026年10月18日確認)
- ChatGPT Learn(Codex公式ドキュメント):Pricing(2026年10月18日確認)
- ChatGPT Learn(Codex公式ドキュメント):Developer commands(CLI)(2026年10月18日確認)
- ChatGPT Learn(Codex公式ドキュメント):Models(2026年10月18日確認)
- OpenAIヘルプ:Response speed and usage resets in Work and Codex(2026年10月18日確認)